JEVANY / 文档
开始使用 JevAny
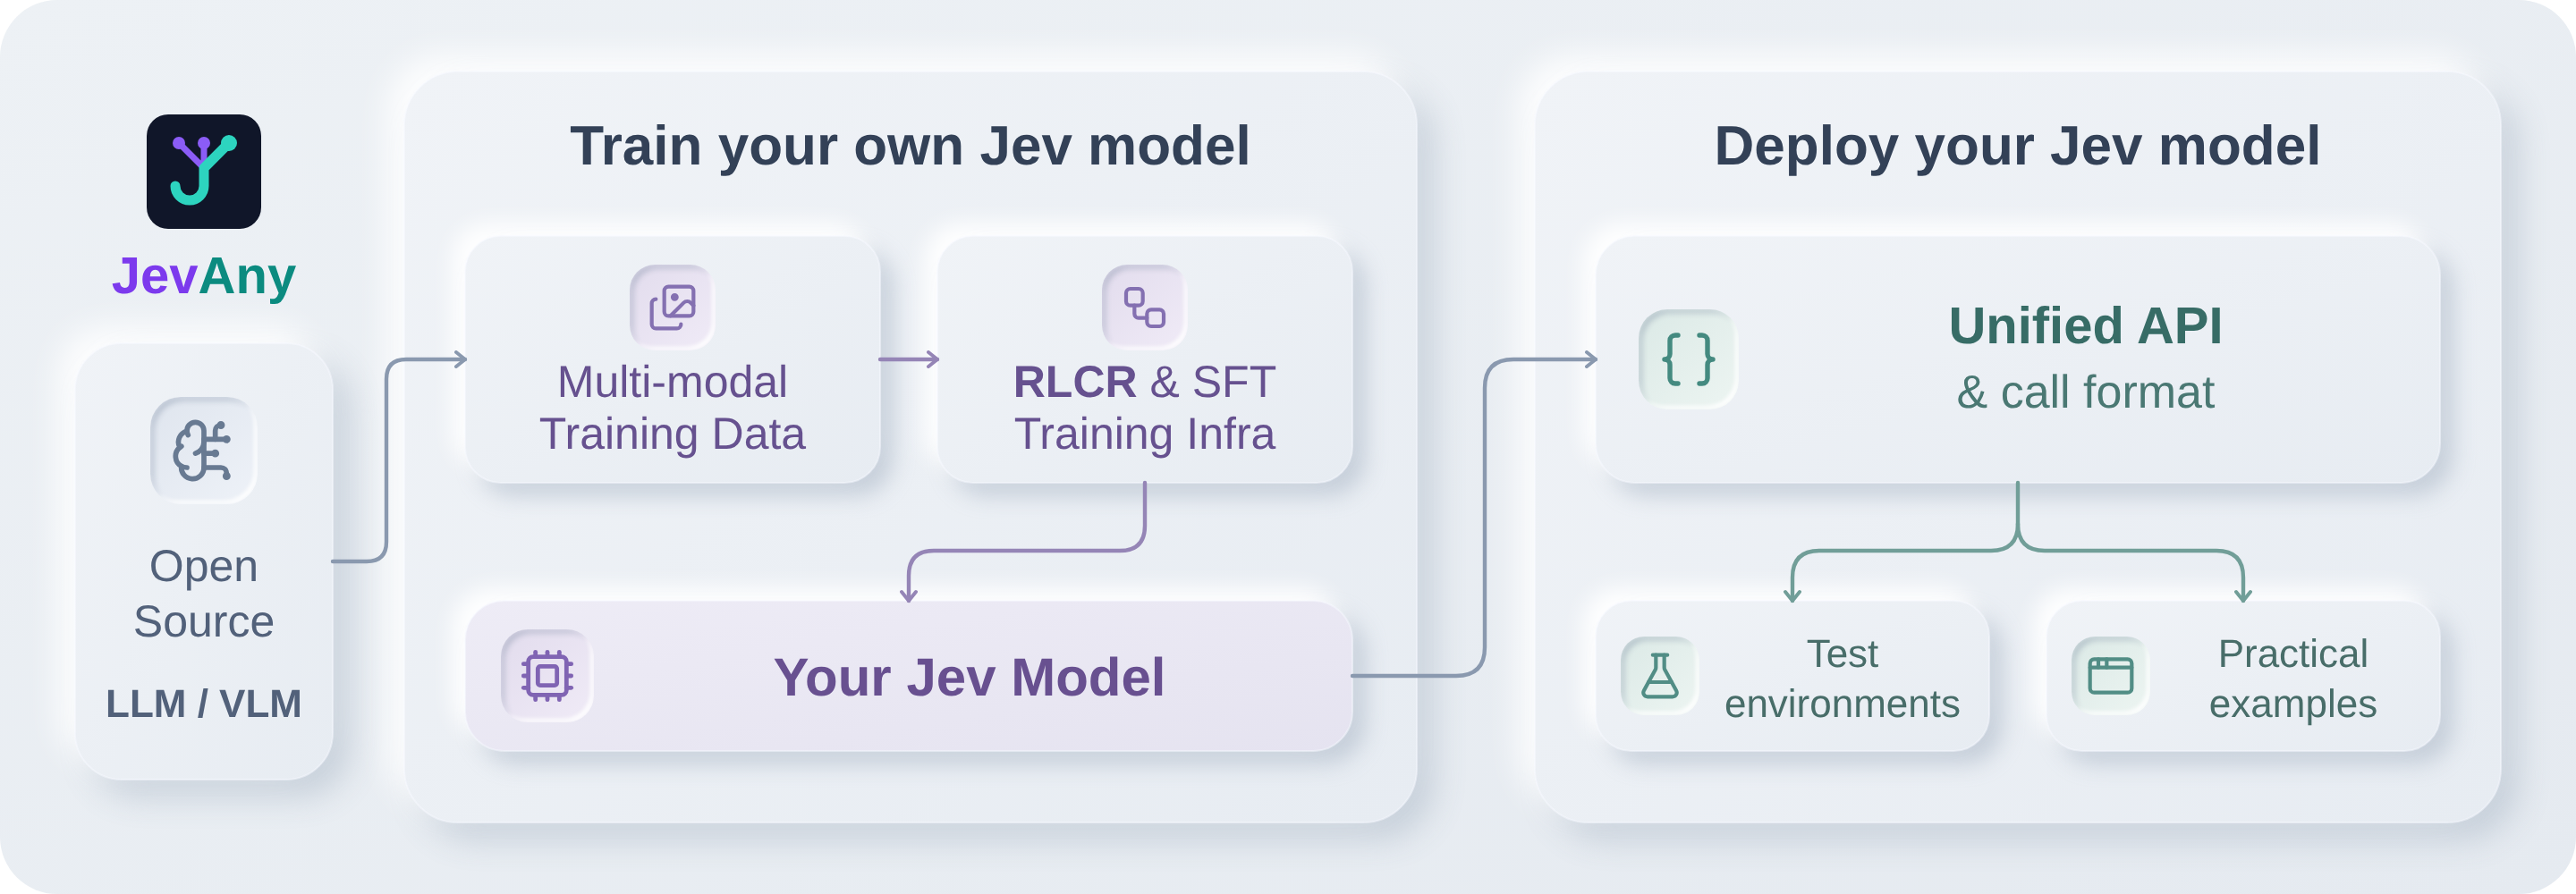
JevAny 是面向 System 1 决策模型训练与部署的开源 infra,涵盖数据准备、模型适配和评测。 你可以直接使用已发布模型,也可以用自己的数据训练,用于工单分流、工具选择和机器人动作决策。 统一 API 接收状态、问题和候选选项,直接返回选择结果与各选项概率。
🎮 结果与演示
以下 30 个案例是由早期兼容 checkpoint 录制的历史回放,展示了 JevAny 在机器人、浏览器、软件、实验室和出行任务中的动作选择; 当前默认发布模型为 JevAny-Qwen3.8-27B。查看全部案例, 或在本地运行模型,输入自己的任务,查看模型的选择和各选项概率。
⚡ Jev 加入 LLM Agent 循环
规划、失败恢复和最终完成由 LLM 负责;当循环中出现有界候选动作时,由 Jev 选择下一步。 每张动图回放一组实测配对,左侧纯 LLM,右侧 LLM + Jev,计时为实测总耗时的加速回放, 步骤画面为示意。
1. WebShop。 Jev 从 LLM 生成的候选中选出所需颜色和尺寸,LLM 随后完成购买。
2. FrozenLake。 LLM 规划一次路线,之后由 Jev 在每个新状态比较四个方向。
3. Terminal-Bench。
在 sqlite-db-truncate 任务中,Jev 从三条探查命令里选择原始页面检查,LLM 随后恢复并验证十行数据。
📑 目录
- 🎮 结果与演示
- ⚡ 1. 快速上手
- 💻 1.1 本地体验
- 🛠️ 1.2 JevAny 训练
- 🚀 1.3 JevAny 部署
- 🤗 2. 预训练模型
- 免训练 choice-token 读出
- 📊 3. 基准测试结果
- ⏱️ 3.1 推理效率
- 🕹️ 4. 示例与测试环境
- 🧩 5. 支持的模型系列
- 📚 6. 文档与贡献
- 🤝 参与贡献
⚡ 1. 快速上手
使用 Python 3.12 或更新版本,克隆仓库并安装轻量客户端:
git clone https://github.com/SimpleJev/JevAny.git
cd JevAny
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install -e .
以下命令均在仓库根目录运行,并使用上述虚拟环境。 先在本地体验,再用自己的数据训练模型,或通过 API 接入应用。
💻 1.1 本地体验
选择适合自己电脑的模型:
| 模型 | 硬件 | 从这里开始 |
|---|---|---|
| Qwen 0.8B 入门配置 | CPU · 建议 16 GB 内存 | 用随包工单训练小型 adapter |
| JevAny-Qwen 4B | CUDA · BF16 基座权重约 8 GB,另需运行时显存 | 加载已发布模型 |
| JevAny-Qwen 27B | CUDA · BF16 基座权重约 54 GB,另需运行时显存 | 选择更大的 checkpoint |
准备和加载步骤见本地模型指南。已发布模型首次使用时下载, 之后复用本地缓存。保持模型服务运行,在同一仓库目录打开第二个终端:
source .venv/bin/activate
jevany demo --base-url http://127.0.0.1:8008 --text-only
打开 http://127.0.0.1:8090,点击 Test and connect,在
Try your own decision 中输入任务,点击 Ask the model。
修改状态或候选选项,观察模型的选择如何变化。
同一界面还提供游戏、机器人和回放。
🛠️ 1.2 JevAny 训练
用标注决策数据训练自己的 System 1 模型:数据沿用推理时的 state 和 questions,
为每个问题增加标签。
先用随包提供的合成客服工单开始训练,再换成自己的标注数据。入门配置在 CUDA 上
以 BF16 训练 Qwen3.5-0.8B,结果写入 runs/my-jev:
python -m pip install -e '.[train]'
jevany data init --out data/starter
jevany data validate data/starter/train.jsonl
jevany train --config recipes/sft.toml --dry-run
jevany train --config recipes/sft.toml
训练完成后,用随包提供的工单请求试用模型:
jevany decide examples/request.json --checkpoint runs/my-jev
通过 --data 指定自己的 JSONL 数据,或用
recipes/finetune.toml 微调已发布的 27B 模型。
CPU 配置、多模态数据和标准 torchrun 启动方式见训练指南。
训练图片/视频模型或微调已发布的 27B 模型时,安装 .[train,multimodal]。
完成 SFT 后,可用实验性的 RLCR 继续训练,其奖励兼顾正确率与概率校准:
jevany train --config recipes/rlcr.toml
🚀 1.3 JevAny 部署
安装推理依赖,在 CUDA GPU 上启动已发布的 Qwen 4B 模型。 显存要求见硬件与加载说明。
python -m pip install -e '.[serve,multimodal]'
jevany serve --checkpoint SimpleJev/JevAny-Qwen3.5-4B-LoRA \
  --device cuda --dtype bf16 --port 8008
默认路径优先保证结果可复现。CUDA 部署可选择 BF16 LoRA 融合、SDPA 和
torch.compile,4B 与 27B 的推荐配置不同。具体命令、H200 实测数据和精度说明见
推理加速指南。
部署自己的训练结果时,将 checkpoint ID 替换为 runs/my-jev。
保持服务运行,在使用相同虚拟环境的 Python 会话中,发送工单和候选处理部门:
from jevany import Choice, JevClient

jev = JevClient("http://127.0.0.1:8008")
result = jev.system_one(
    state={"ticket": "I was charged twice. Please help."},
    questions={
        "department": Choice(
            instructions="Which team should handle this?",
            criteria={"billing": "Payment problems", "shipping": "Delivery problems"},
        ),
    },
)
answer = result["answers"]["department"]
print("Selected team:", answer["choice"])
print("Probabilities:", answer["probabilities"])
choice 返回一个候选部门名称,probabilities 返回各部门的概率。
你可以据此分配工单,也可以在结果不确定时转交人工审核。
二分类问题使用 Noul,例如判断工单是否需要紧急处理;有序评分使用 Score,
例如低、普通、高三个优先级。三类问题的完整格式见 API 文档。
进程内推理可以在 Python 中加载模型,通过相同接口调用。 图片和视频输入见媒体配置。
🤗 2. 预训练模型
第一次在本地运行,可以先按本地体验中的硬件要求选择模型。
| 模型 | Readout | 用途 |
|---|---|---|
 JevAny-Gemma-4B |
Pointer | 轻量 Gemma 版本 |
 JevAny-Qwen3.5-4B |
Pointer | 轻量、支持灵活选项数 |
| JevAny-Qwen3.5-4B-Direct-Token |
Direct-token | 当前 4B JevBench 最优版本 |
| JevAny-Qwen3.8-27B |
Pointer | 默认模型;当前发布准确率最高 |
 JevAny-Muse-Glimmer-30B |
Pointer | Muse Glimmer 版本 |
这些 LoRA adapter 采用 SFT 训练,训练数据包含 1,772,725 条文本记录和 2,180,242 个有标签决策, 配置见训练算力与实验说明。 全参数 SFT 与进一步的后训练改进仍在计划中。
加载时还需要对应基座,并适用基座模型的许可证和访问条款。BF16 基座权重大约 需要参数量两倍的字节数,另需运行时显存。详见硬件与加载说明。
Pointer 和 direct-token 模型使用相同 API。Pointer 在上下文允许的范围内支持最多 4,096 个选项,direct-token 最多支持 255 个。 训练与准确率的取舍见输出方式说明。
免训练 choice-token 读出
Choice-token 是一种无需额外训练的读出方式,最多支持 52 个选项:用单 token 的
A–Z, a–z 给选项编号,在回答位置读取这些 ID 的 logits 并重新归一化。
它既可用于冻结的基座模型,也可叠加在 Pointer / Direct-Token checkpoint 上;
与温度校准不同,它可能改变最终选出的答案。
jevany eval --run SimpleJev/JevAny-Qwen3.5-4B-Direct-Token-LoRA \
  --suite /path/to/suite --out runs/choice --device cuda --readout choice
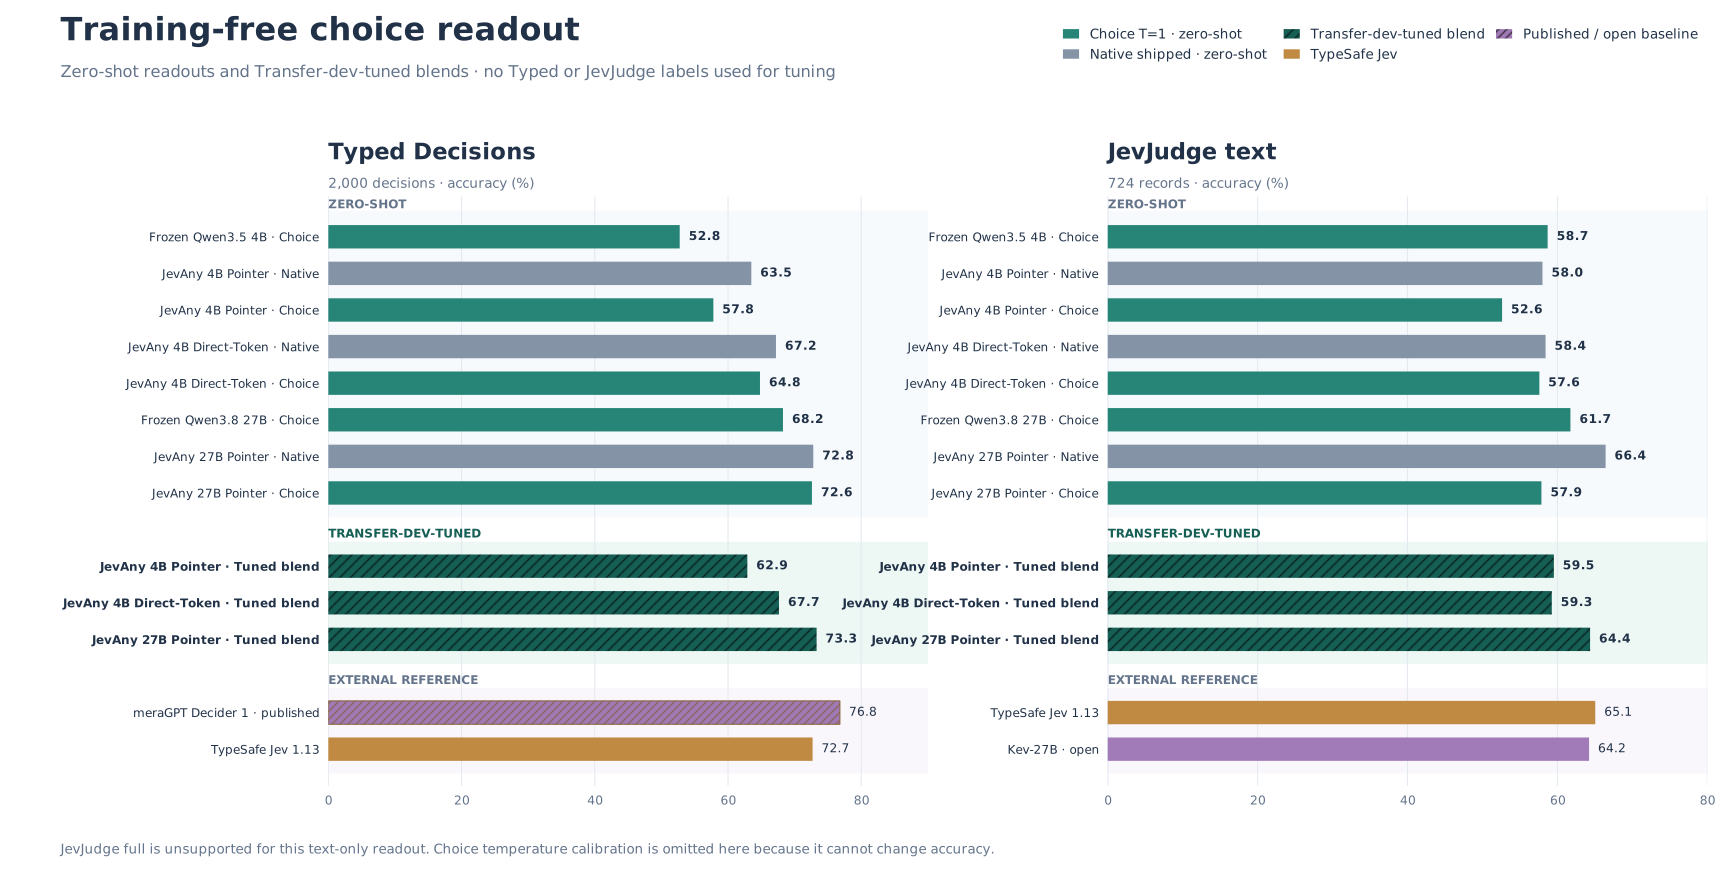
- 最佳 4B 混合:Direct-Token 达到 Transfer 79.83%、Typed 67.65%、 JevJudge 文本 59.25%,比原生读出分别高 0.96、0.45 和 0.83 个点。
- 最佳 27B 混合:Pointer 达到 Transfer 89.10%、Typed 73.30%, 但 JevJudge 文本从 66.44% 降到 64.36%。
- 训练仍然重要:冻结的 4B 基座在 Typed 上只有 52.75%, Direct-Token 将其提升到 64.80%。
在开发集上只调一个混合权重,评测前冻结;仅当原生读出与 choice 读出的错误 互补时才使用混合。温度只改变置信度,不改变 argmax。
指标说明:Cygnet 的 73.70 是 v1.5.4 在 1,624 条公开与封闭题目上的 综合分,不是准确率;其可比的公开开发集准确率为 203/231(87.9%)。
核心结论:当瓶颈在于“把决策提取出来”而非推理能力时,choice-token 有帮助; 只有在目标分布的留出数据上确有提升时才保留混合。
📊 3. 基准测试结果
下表使用各 checkpoint 的原生读出方式。 JevAny-Qwen3.8-27B 在两项评测中准确率最高,NLL 和 Brier 也最低。 4B 版本中,direct-token 的 JevBench 准确率最高,Pointer 的 Transfer 准确率最高。
 Kev-4B](https://huggingface.co/jaredpalmer/kev-4b) | 74.19% | 75.32% | 0.858 | 0.380 | 0.125 |
| [ Kev-27B](https://huggingface.co/jaredpalmer/kev-27b) | 82.31% | 85.28% | 0.533 | 0.265 | 0.050 |
| [
 Jev 1.13.0](https://docs.typesafe.ai/models) | 85.37% | 86.58% | 0.644 | 0.212 | 0.033 |
| [
 Laya](https://huggingface.co/convaiinnovations/laya) | 52.29% | 58.01% | 1.264 | 0.615 | 0.127 |
| **JevAny Releases** | | | | | |
| [ JevAny-Gemma-4B](https://huggingface.co/SimpleJev/JevAny-Gemma-4B-LoRA) | 70.84% | 77.49% | 0.706 | 0.369 | 0.056 |
| [ JevAny-Qwen3.5-4B](https://huggingface.co/SimpleJev/JevAny-Qwen3.5-4B-LoRA) | 78.68% | 80.09% | 0.587 | 0.297 | 0.035 |
| [ JevAny-Qwen3.5-4B-Direct-Token](https://huggingface.co/SimpleJev/JevAny-Qwen3.5-4B-Direct-Token-LoRA) | 78.20% | 80.95% | 0.564 | 0.291 | **0.029** |
| [ JevAny-Muse-Glimmer-30B](https://huggingface.co/SimpleJev/JevAny-Muse-Glimmer-30B-LoRA) | 83.46% | 87.45% | 0.464 | 0.229 | 0.032 |
| [ **JevAny-Qwen3.8-27B**](https://huggingface.co/SimpleJev/JevAny-Qwen3.8-27B-LoRA) | **86.04%** | **90.04%** | **0.388** | **0.195** | **0.026** |
NLL、Brier 和 ECE 均在 Transfer 上计算。
完整结果与评测协议 · 机器可读结果 · 方法与消融实验报告
同一组 13 个模型按准确率在 Typed Decisions、JevJudge 全集(3,220 条多模态记录)
及其 724 条文本子集上进行比较。— 表示不支持该输入或没有对应结果。
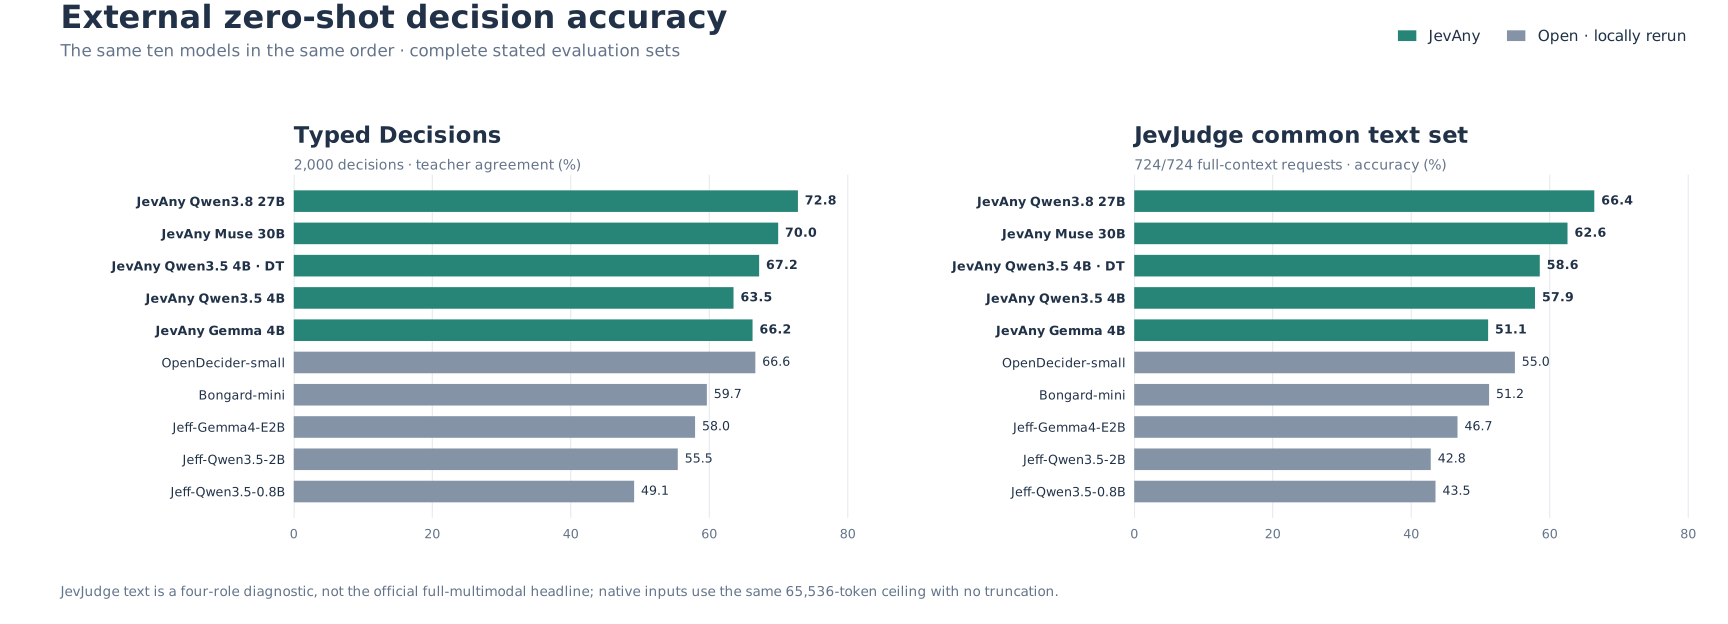
- JevAny-Qwen3.8-27B:Typed 72.8%,JevJudge 全集 62.3%,文本子集 66.4%; 其他有全集结果的模型中最强的是 Jeff-Qwen3.5-2B,为 48.2%。
- 其他基线:Jev 1.13 的 Typed 为 72.7%,文本子集为 65.1%;Kev-27B 文本子集为 64.2%。公开的 Decider 1 和 Liquid d1 在 Typed 上领先, 分别为 76.8% 和 74.2%,但没有可比的全集结果。
⏱️ 3.1 推理效率
在单张 H200 上,CUDA Graph 将 Qwen3.8-27B 的中位延迟从 113.54 ms 降至 30.53 ms(3.72×);融合 SDPA 加 CUDA Graph 将 Muse-Glimmer-30B 从 100.71 ms 降至 43.25 ms(2.33×)。 两次测量均未改变 argmax。下表对 27B 与 30B 使用 H200 headline 实测, 对 4B 保留同硬件 A100-40GB 对照。每个加速比只在同一行内比较;H200 与 A100 使用不同固定面板,不能横向比较绝对延迟。
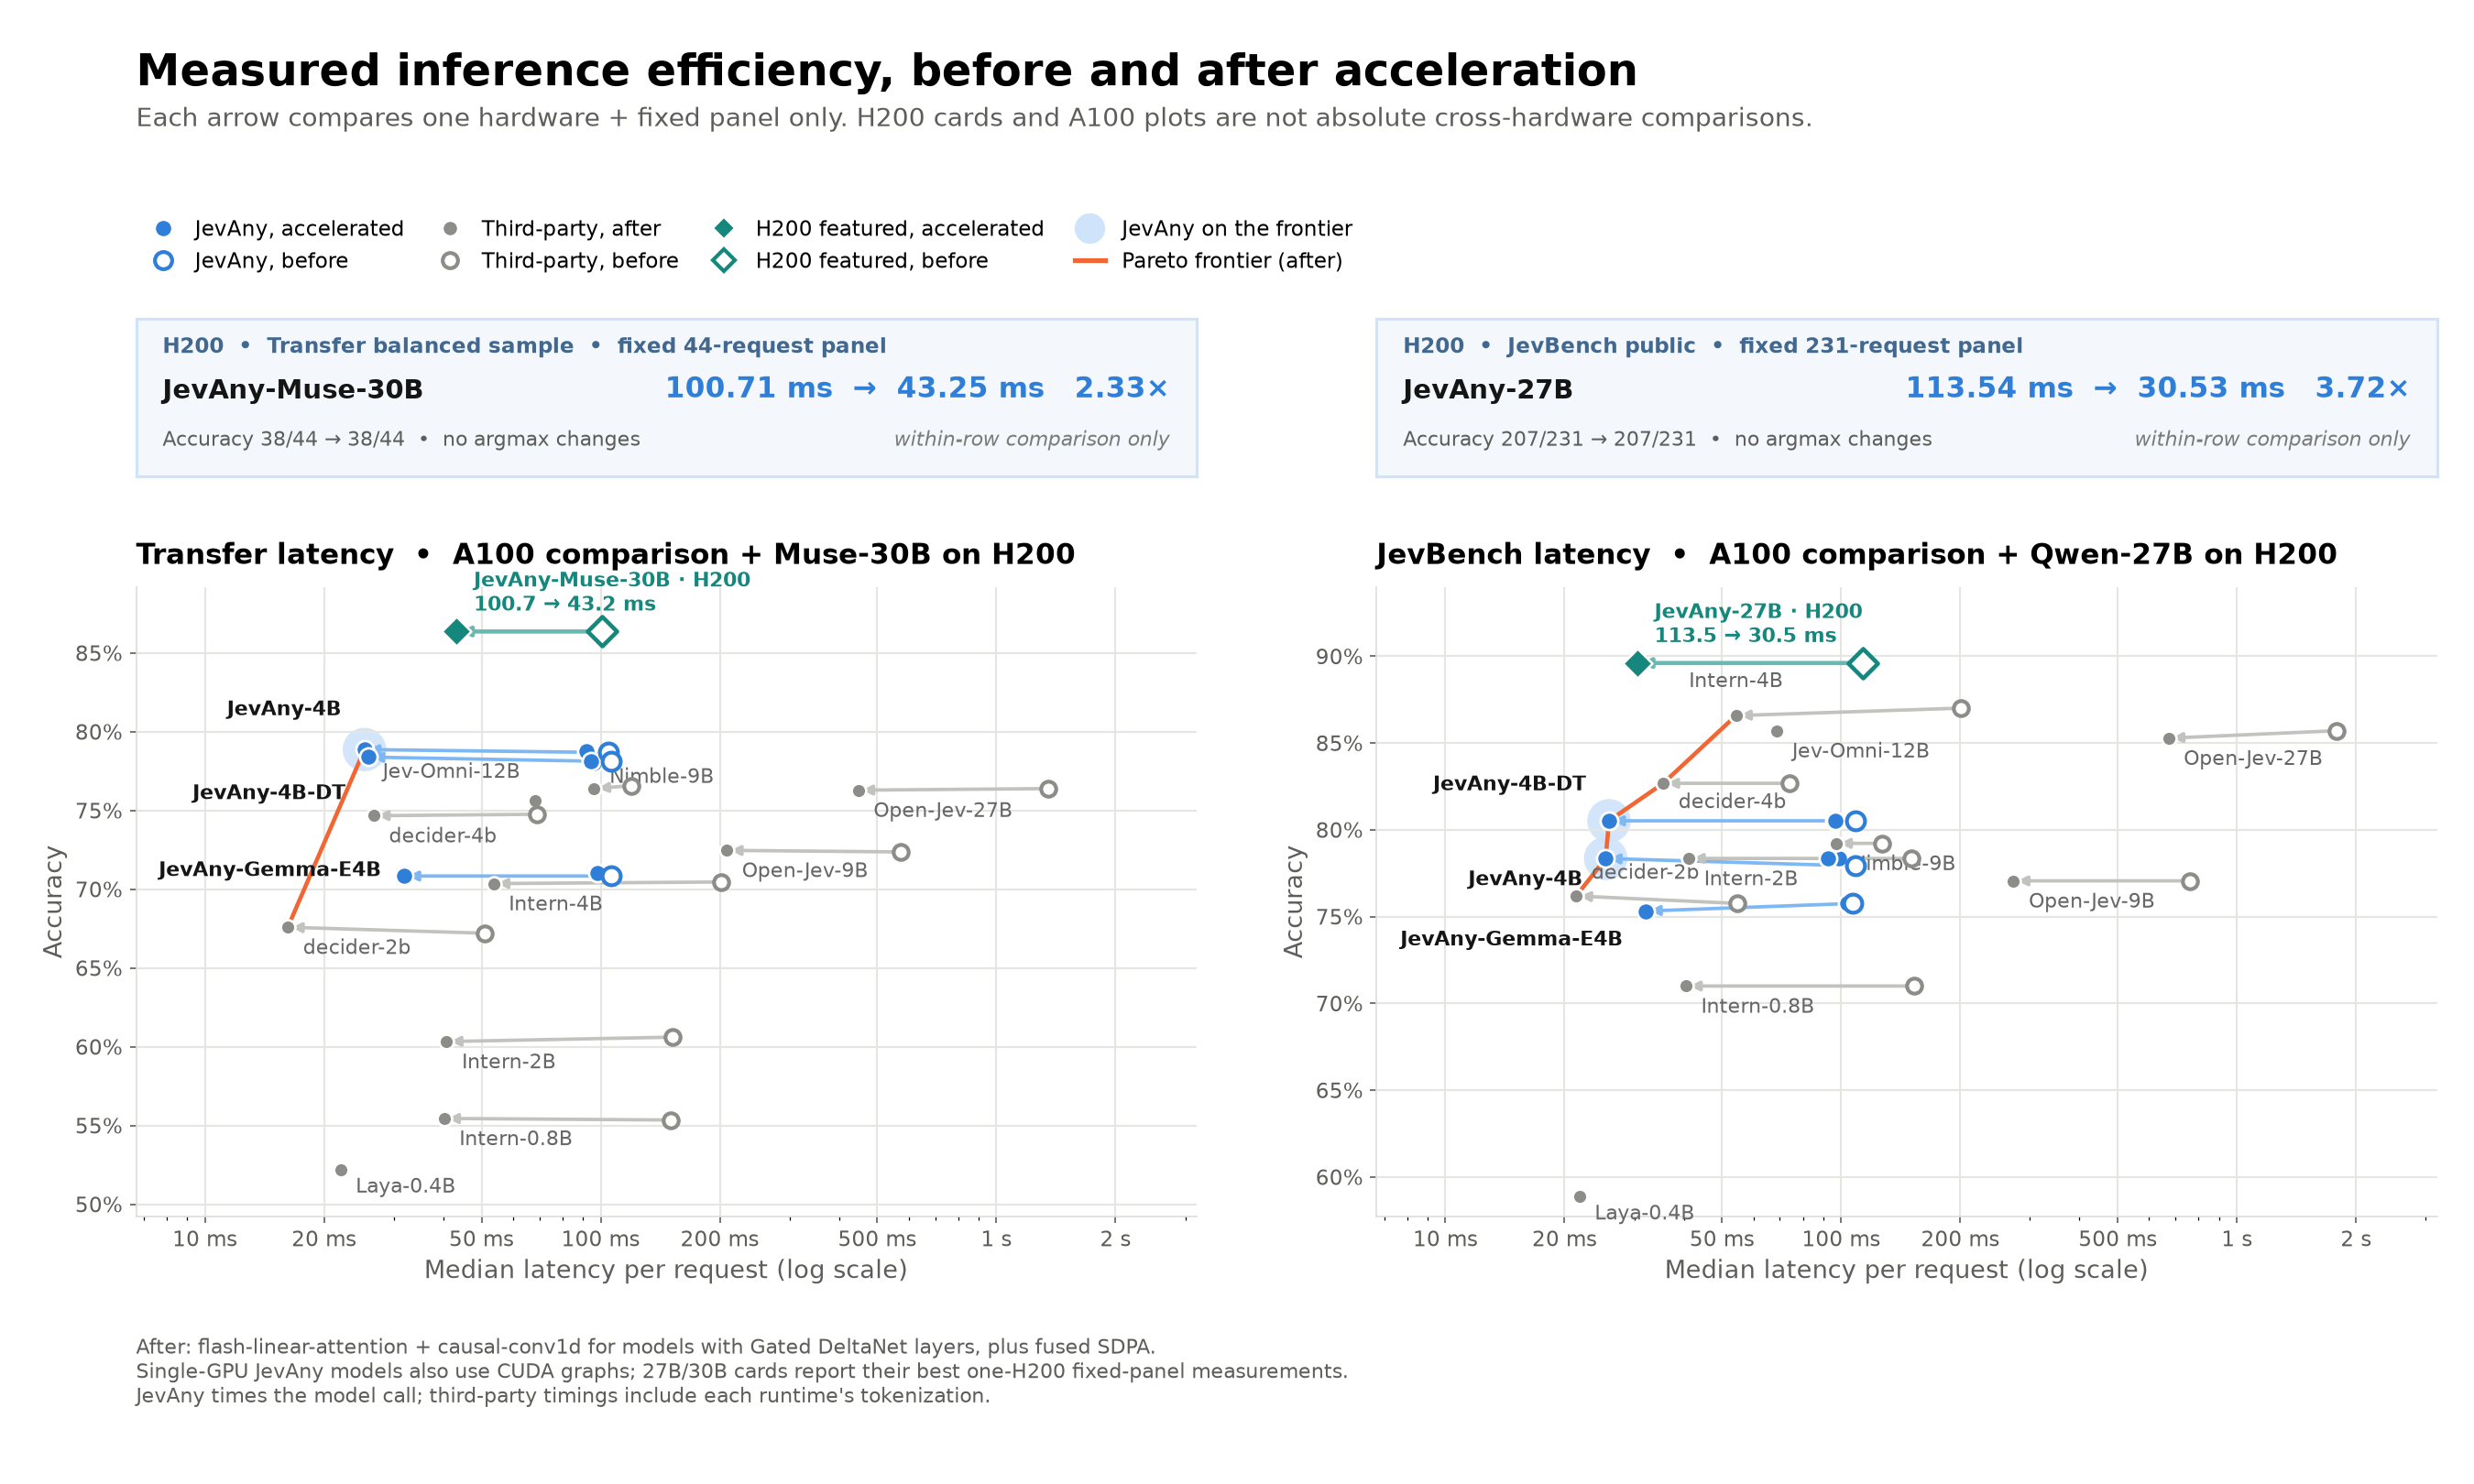
| 模型 | 硬件 | 加速前 | 加速后 | 加速比 | 准确率检查 | 固定面板 |
|---|---|---|---|---|---|---|
| JevAny-Qwen3.5-4B | A100 | 104.6 ms | 25.3 ms | 4.1× | 78.68% → 78.87% | Transfer,1,046 |
| JevAny-Qwen3.5-4B-Direct-Token | A100 | 106.4 ms | 25.9 ms | 4.1× | 78.11% → 78.39% | Transfer,1,046 |
| JevAny-Gemma-4B | A100 | 106.3 ms | 31.9 ms | 3.3× | 70.84% → 70.84% | Transfer,1,046 |
| JevAny-Muse-Glimmer-30B | H200 | 100.71 ms | 43.25 ms | 2.33× | 86.36% → 86.36% | Transfer 样本,44 |
| JevAny-Qwen3.8-27B | H200 | 113.54 ms | 30.53 ms | 3.72× | 89.61% → 89.61% | JevBench public,231 |
中位模型调用延迟,串行 batch size 1。完整报告保留同硬件 A100 对照与面板限制。
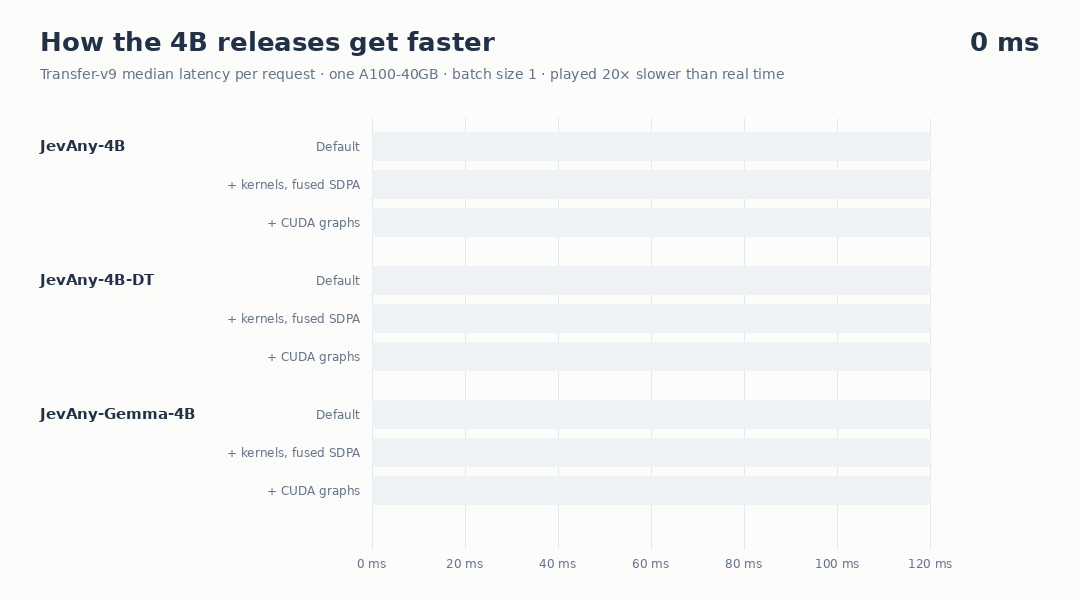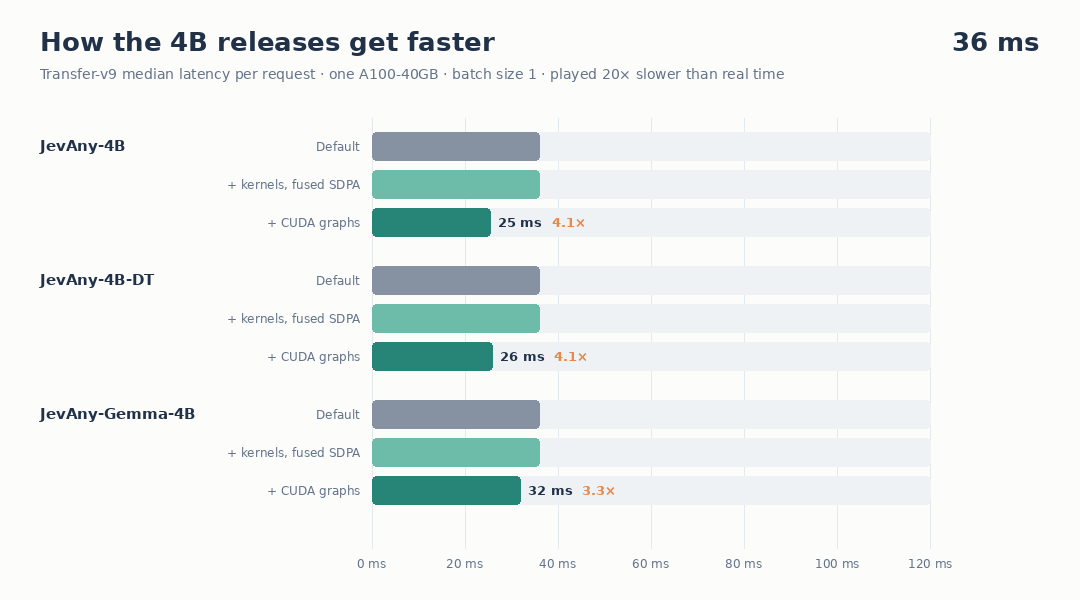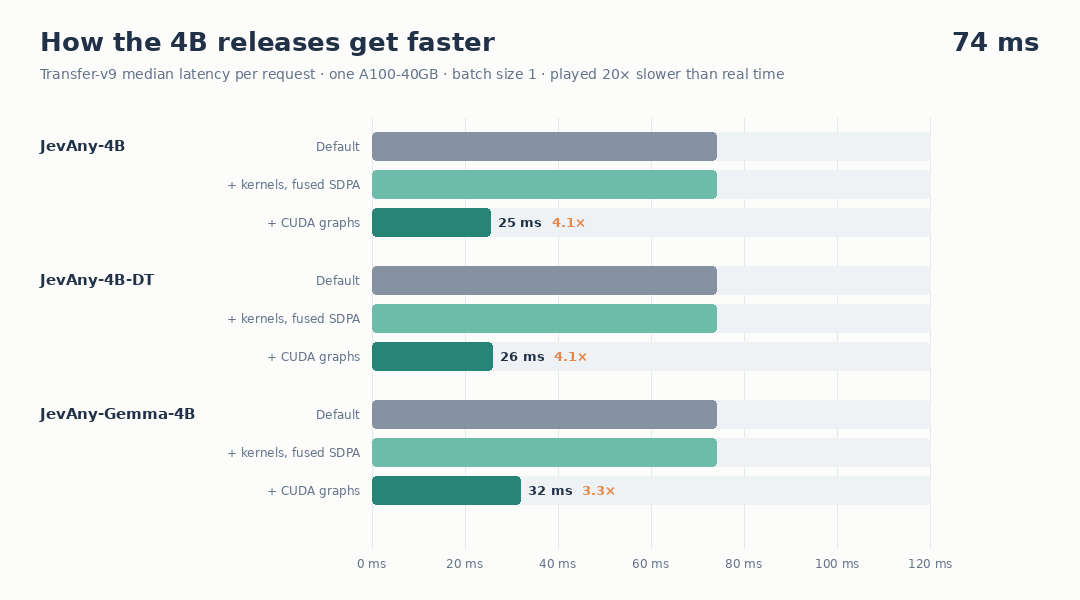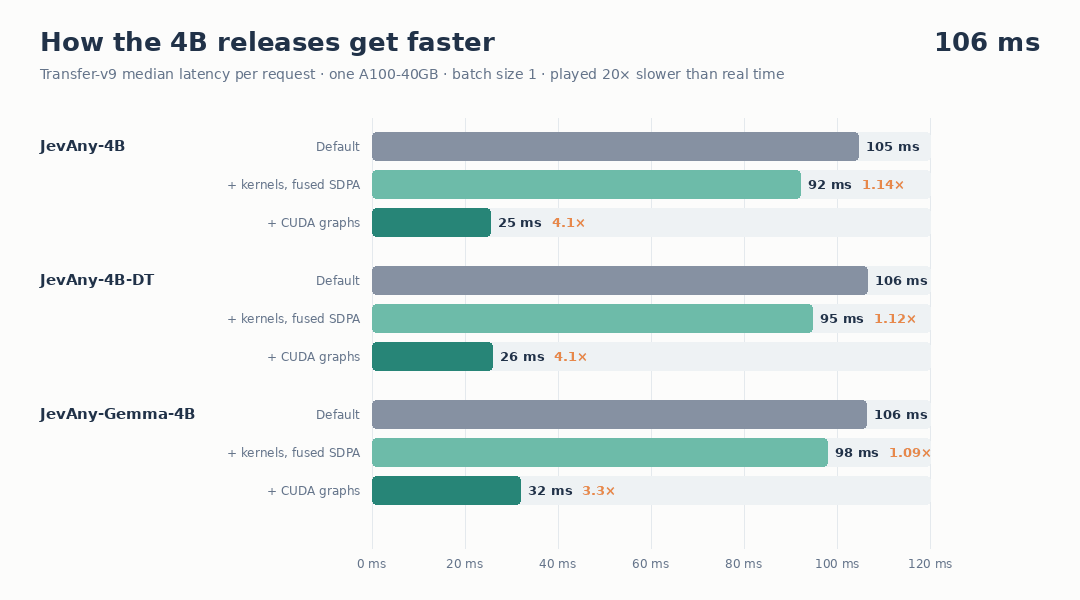
A100 上的 4B 与 H200 上的 27–30B。每行按各自 baseline 归一化,只在行内比较优化阶段。
完整表格、实验设置与其他模型 · 开启方法 · H200 机器可读结果 · A100 机器可读结果
🕹️ 4. 示例与测试环境
交互演示包含以下三个环境。动图保留历史模型的动作和选项概率;当前 JevAny-Qwen3.8-27B 可按 playground 指南中的命令运行。
🤖 4.1 机械臂插孔
控制 Franka 夹爪抓取、对准并插入工件,由 PyBullet 接触物理验证结果。
🔫 4.2 Doom 走廊 · 3D
击败最后一个房间中左右两侧的敌人,再向前移动。使用 ViZDoom 和随包提供的 Freedoom 资源。
⛏️ 4.3 Crafter 生存建造 · 2D
采集木材、制作工具、开采石头,同时管理生命值和物资。
🎮 4.4 打开交互演示
按本地体验启动模型后,打开交互演示:
jevany demo --base-url http://127.0.0.1:8008 --text-only
打开 http://127.0.0.1:8090,点击 Test and connect,尝试自己的决策任务。
要让模型操作游戏,安装可选引擎并重新启动演示:
python -m pip install -e '.[demo]'
jevany demo --base-url http://127.0.0.1:8008 --text-only
在浏览器中选择 Run model,再点击 One decision 单步运行,或
Run automatically 连续运行。选择 Play yourself 可以自己操作。
实时控制向模型发送文本状态;机械臂控制使用 .[robotics] 依赖。
观看内置录制内容时,运行 jevany demo 并选择 Replay,只需 CPU,无需模型权重。
平台要求与环境接口见演示指南,结合 LLM 规划器使用
JevAny 决策可参考集成文档。
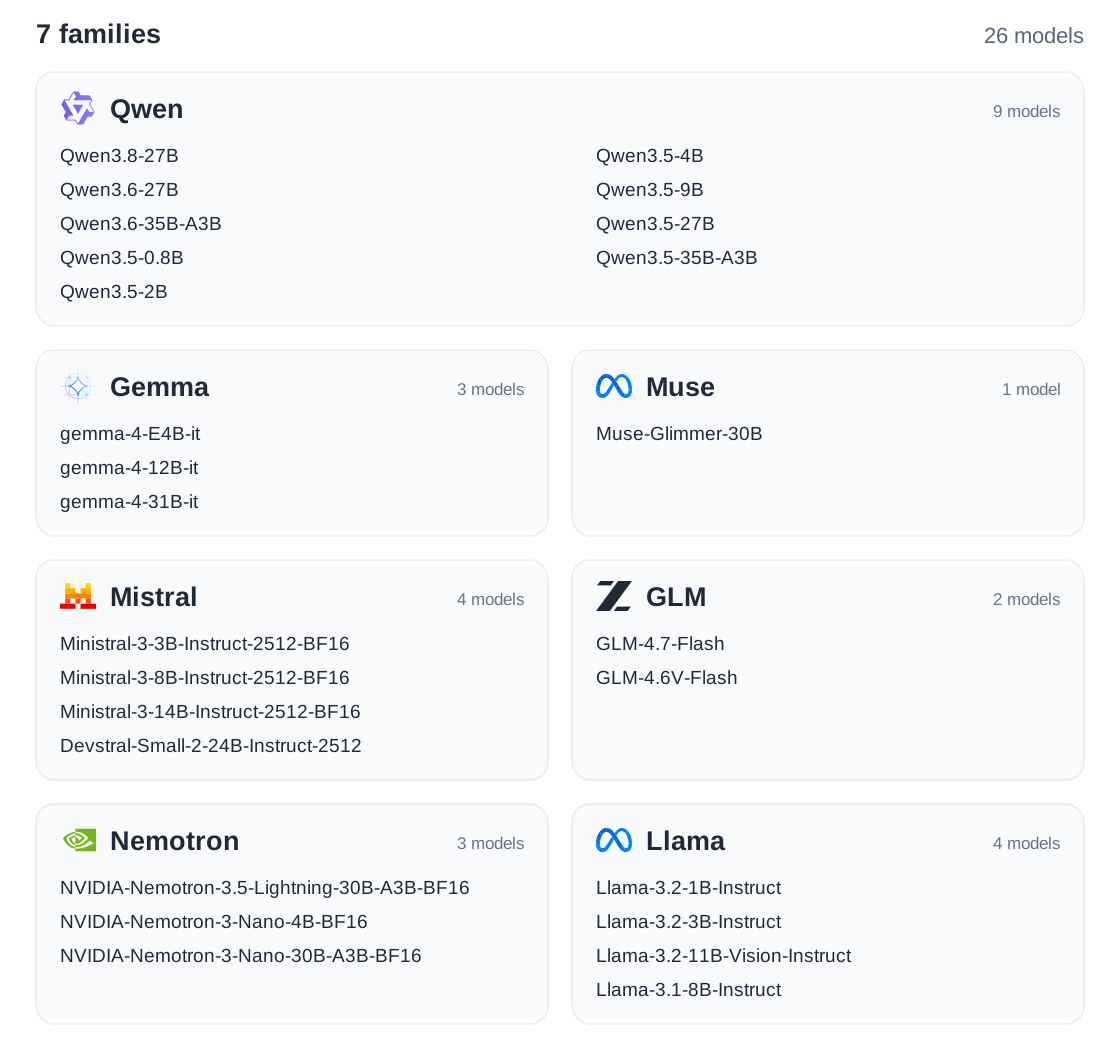
🧩 5. 支持的模型系列
📚 6. 文档与贡献
文档总览 · 训练 · 部署 · API · 数据 · 评测 · Agent harness 协议 · 贡献指南
技术报告介绍了模型设计、多模态路径、 agent-harness 实验与附录、负面结果和开放问题。
代码和入门数据采用 Apache-2.0。部分组件改编自 Kev, 归属说明见 NOTICE 和 致谢与归属。 基座模型与上游数据集保留各自条款。
🤝 参与贡献
我们正在建设面向 System 1 决策模型的开源基础设施,欢迎你一起参与。 从你熟悉的地方开始,小改进也很有帮助:
- 文档与翻译:说明一个安装步骤、补充排错经验,或翻译一篇指南。
- 问题修复与测试:提供问题复现、修复 bug,或补上回归测试。
- 应用与集成:展示如何用 JevAny 选择工具、分流工单,或在游戏和机器人环境中选择动作。
- 模型、训练与推理:适配一个模型、改进训练配置,或提交有可复现测量结果的推理加速方案。
- 数据与评测:贡献公开数据转换工具、补充评测用例,或记录模型做出错误决策的场景。
提交 PR 后,CI 检查和自动 AI code review 会提供反馈,维护者负责审核与合并。 小修复可以直接提交 PR,较大的改动建议先开 issue 讨论方案。